Computer Vision[33]
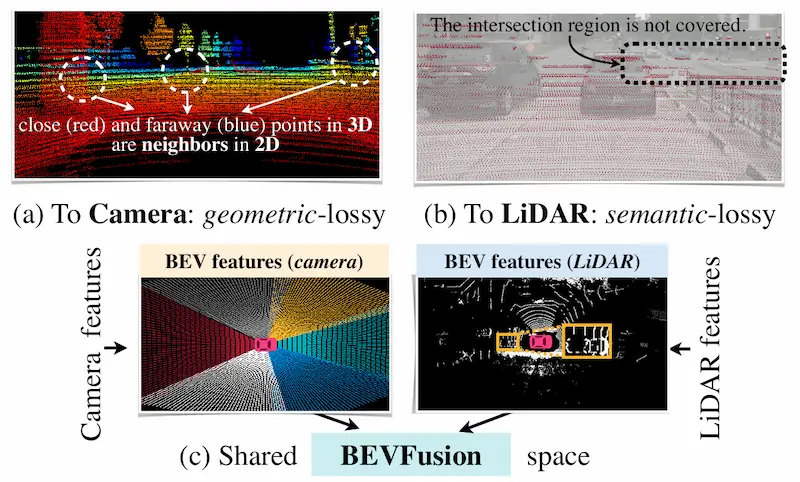
【重读经典】BEVFusion: Multi-Task Multi-Sensor Fusion with Unified Bird's-Eye View Representation
自动驾驶常见传感器包括 Camera,LiDAR,Radar 等传感器。 相机能提供丰富语义,LiDAR 提供准确的空间信息,雷达能进行速度估计。 对于多传感器方案,当时的传感器投影存在信息损失的问题: LiDAR->Cam:存在几何损失,像素坐标系中相邻的像素点,在 3D 空间中可能距离很远。设想
nuscenes-devkit的使用
nuScenes数据集说明 - FunnyWii's Zone 一文了解nuScenes数据集的结构。 我们使用nuscenes-devkit进一步学习数据集的使用。 安装非常简单,建议python版本3.12和3.9。 pip install nuscenes-devkit devkit使用 仍以
nuScenes数据集说明
nuScenes数据集包含6个Camera,1个LiDAR,5个Radar,1个GPS以及IMU。 数据量比KITTI大得多,所以目前Occ Networks更多使用nuScenes数据集。 数据集分成两大块:Full和Mini。 Full Dataset包含140万Camera图像,39万LiDA
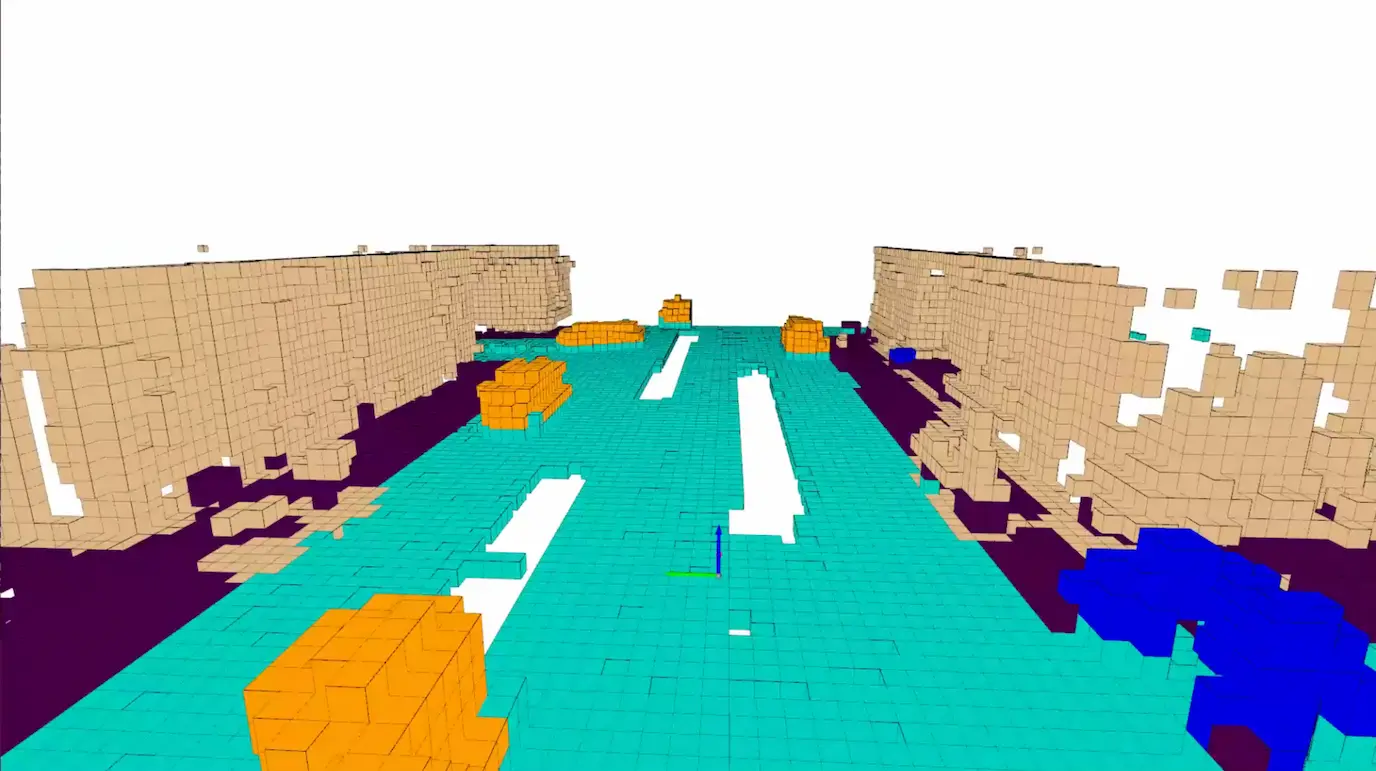
Ubuntu22部署FlashOcc踩坑实录
环境配置 conda create --name FlashOcc python=3.8.5
conda activate FlashOcc
pip install torch==1.10.0+cu111 torchvision==0.11.0+cu111 torchaudio==0.10.0 -f
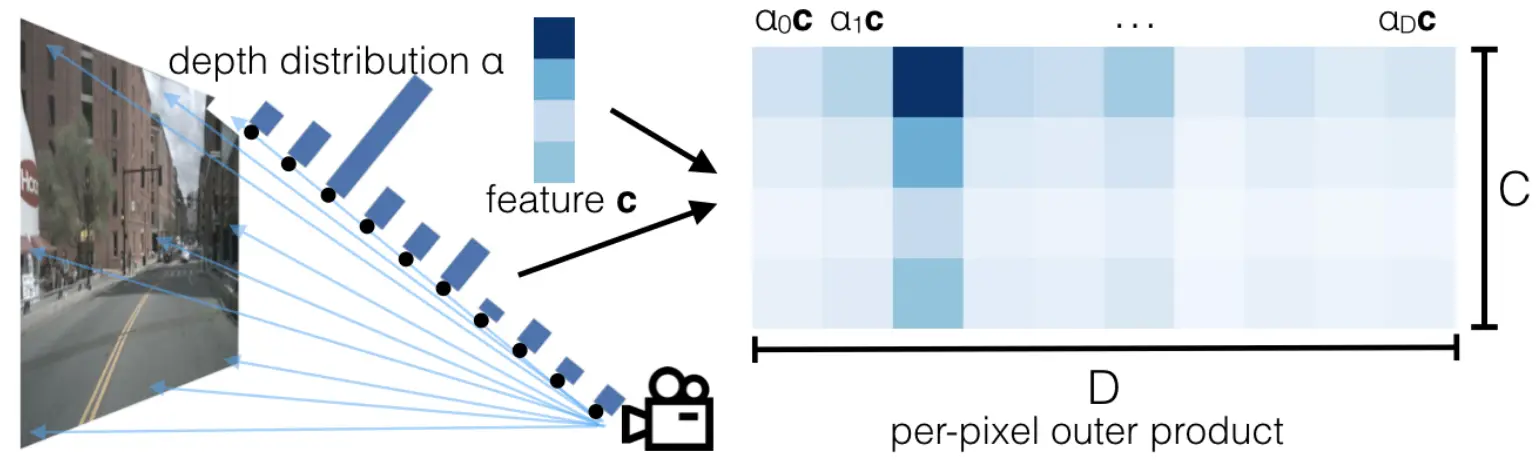
【重读经典】Lift, Splat, Shoot: Encoding Images From Arbitrary Camera Rigs by Implicitly Unprojecting to 3D
LSS 是 NVIDIA 在 ECCV2020 上发表的文章。 关于论文标题中 Lift, Splat, Shoot 三个单词的理解,这三个单词对应模型中三个核心步骤。 Lift:提升。2D 图像特征提升到 3D 视锥空间特征。 Splat:泼溅。所有相机生成的 3D 视锥特征,泼洒到统一的 BEV
【重读经典】3D Bounding Box Estimation Using Deep Learning and Geometry
Deep3DBox 是一篇比较早的使用单目相机进行3D目标检测和姿态估计的方法。 Deep3DBox 先用 CNN 回归目标的方向和尺寸,因为这两类属性稳定性比较高。然后结合 2D BBOX 的几何约束求解平移量,以生成完整的 3D BBOX。 有些方法基于 PnP,通过 2D-3D 关键点对应关系
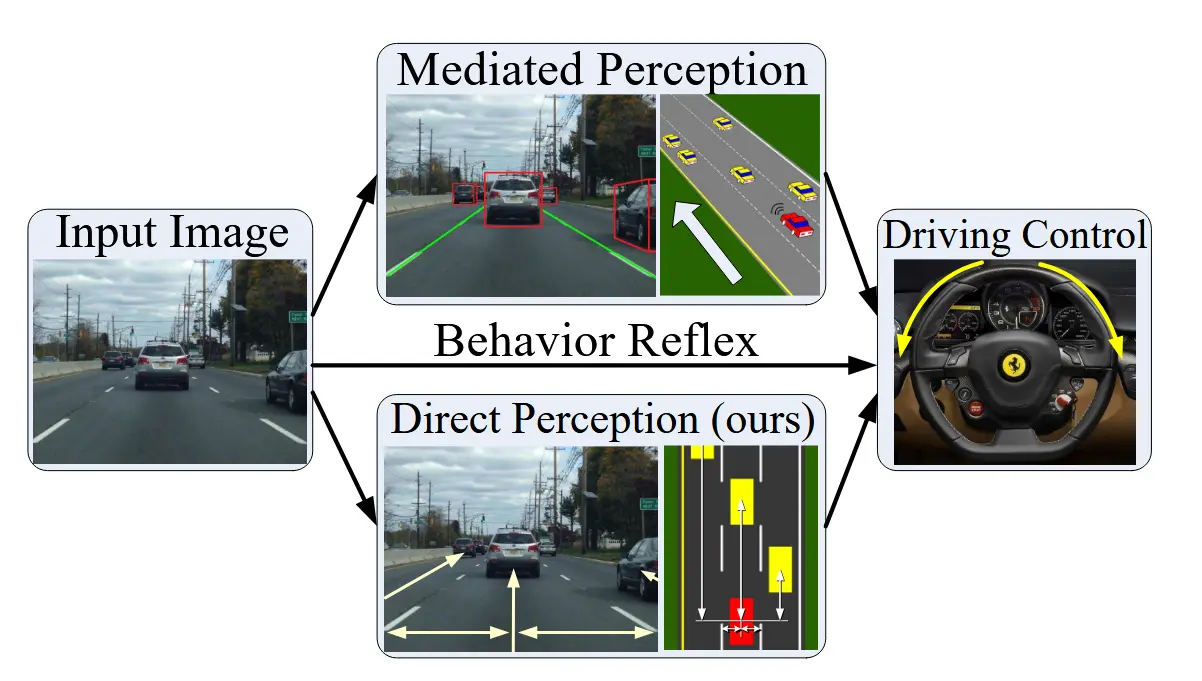
【重读经典】DeepDriving: Learning Affordance for Direct Perception in Autonomous Driving
标题中的 Affordance 一词,本意是”预设用途,功能特性“,最初在知觉心理学和设计学领域出现。 后来在人机交互领域,Affordance 的含义变成了:一个产品让用户自然领悟到用法的能力。 在机器人领域(自动驾驶和机器人的感知不分家),被引申为可以执行的潜在动作,即在特定情况下哪些动作是可执

多传感器融合——后融合
多传感器融合的方案可以分成前融合(Early Fusion)方案和后融合(Late Fusion)方案。 前融合也叫特征级融合,不同传感器的数据会在特征级别进行合并,也就是说,不同模态的数据经过处理和合并后会得到一个特征集合。一般来说,每个模态数据的特征会被分别提取,然后被提取到的特征会被合并为一个

计算机视觉中的Affine和Perspective Transformation
Affine Transformation 仿射变换是在二维空间上对图像进行平移(Translation)、缩放(Scale)、旋转(Rotate)、错切(Shear)操作的组合。 四种变换的矩阵形式分别为: 平移:T_t = \begin{bmatrix} 1 & 0 & p_x \\ 0 & 1
学习Transformer
Transformer 在谷歌 2017 年的论文 [\1706.03762] Attention Is All You Need 中首次被提出,主要用于 NLP(Natural Language Processing,自然语言处理)的各项任务。 后来在 CV 领域,研究者们基于 Transform